
可复现研究
回到实验,而不是重新配置环境。
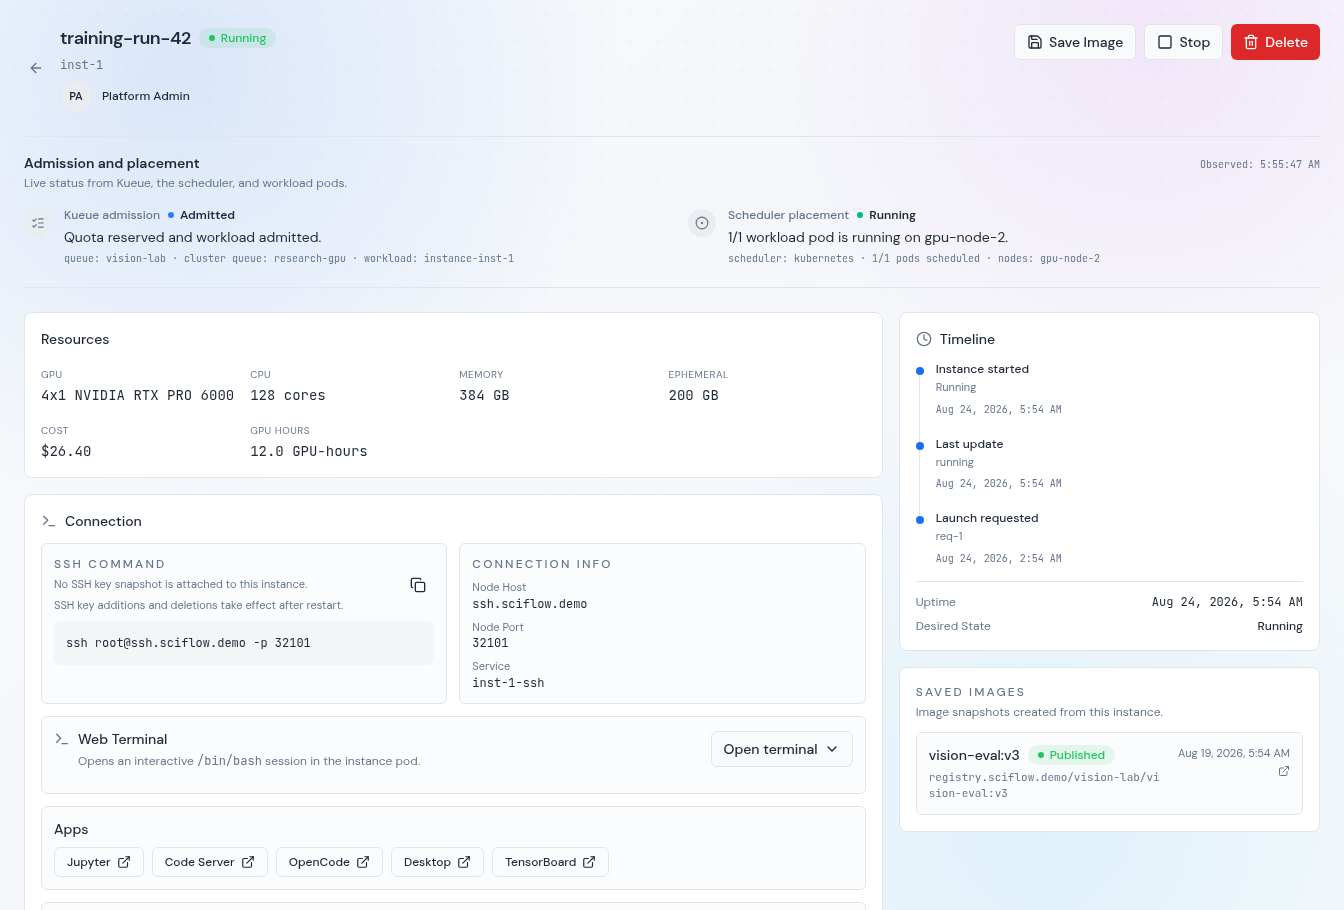
启动已经维护好的 GPU 环境,项目存储和访问入口随之就绪。当环境验证可用后,将它保存为镜像,让协作者和未来的任务都从同一状态开始。
让结果保留上下文。
代码、依赖、数据挂载和算力历史始终与研究工作相连,不再散落在安装笔记和聊天记录里。
SciFlow
启动可复现的 GPU 环境、扩展训练、对比实验结果,并与理解基础设施的智能体共同工作。
适用于运行私有或本地 GPU 集群的实验室。
从探索到证据,始终将环境、训练任务、实验结果与智能体上下文连接在一起。
可复现研究
启动已经维护好的 GPU 环境,项目存储和访问入口随之就绪。当环境验证可用后,将它保存为镜像,让协作者和未来的任务都从同一状态开始。
让结果保留上下文。
代码、依赖、数据挂载和算力历史始终与研究工作相连,不再散落在安装笔记和聊天记录里。
规模化实验
描述工作负载,选择保障或可回收容量,并从准入到完成跟踪每个 rank。SciFlow 让共享 GPU 成为可预测的研究仪器。
等待也有明确原因。
研究者无需追问平台团队或阅读 Kubernetes 事件,也能看到任务为何等待、占用了哪些资源,以及失败发生在哪里。
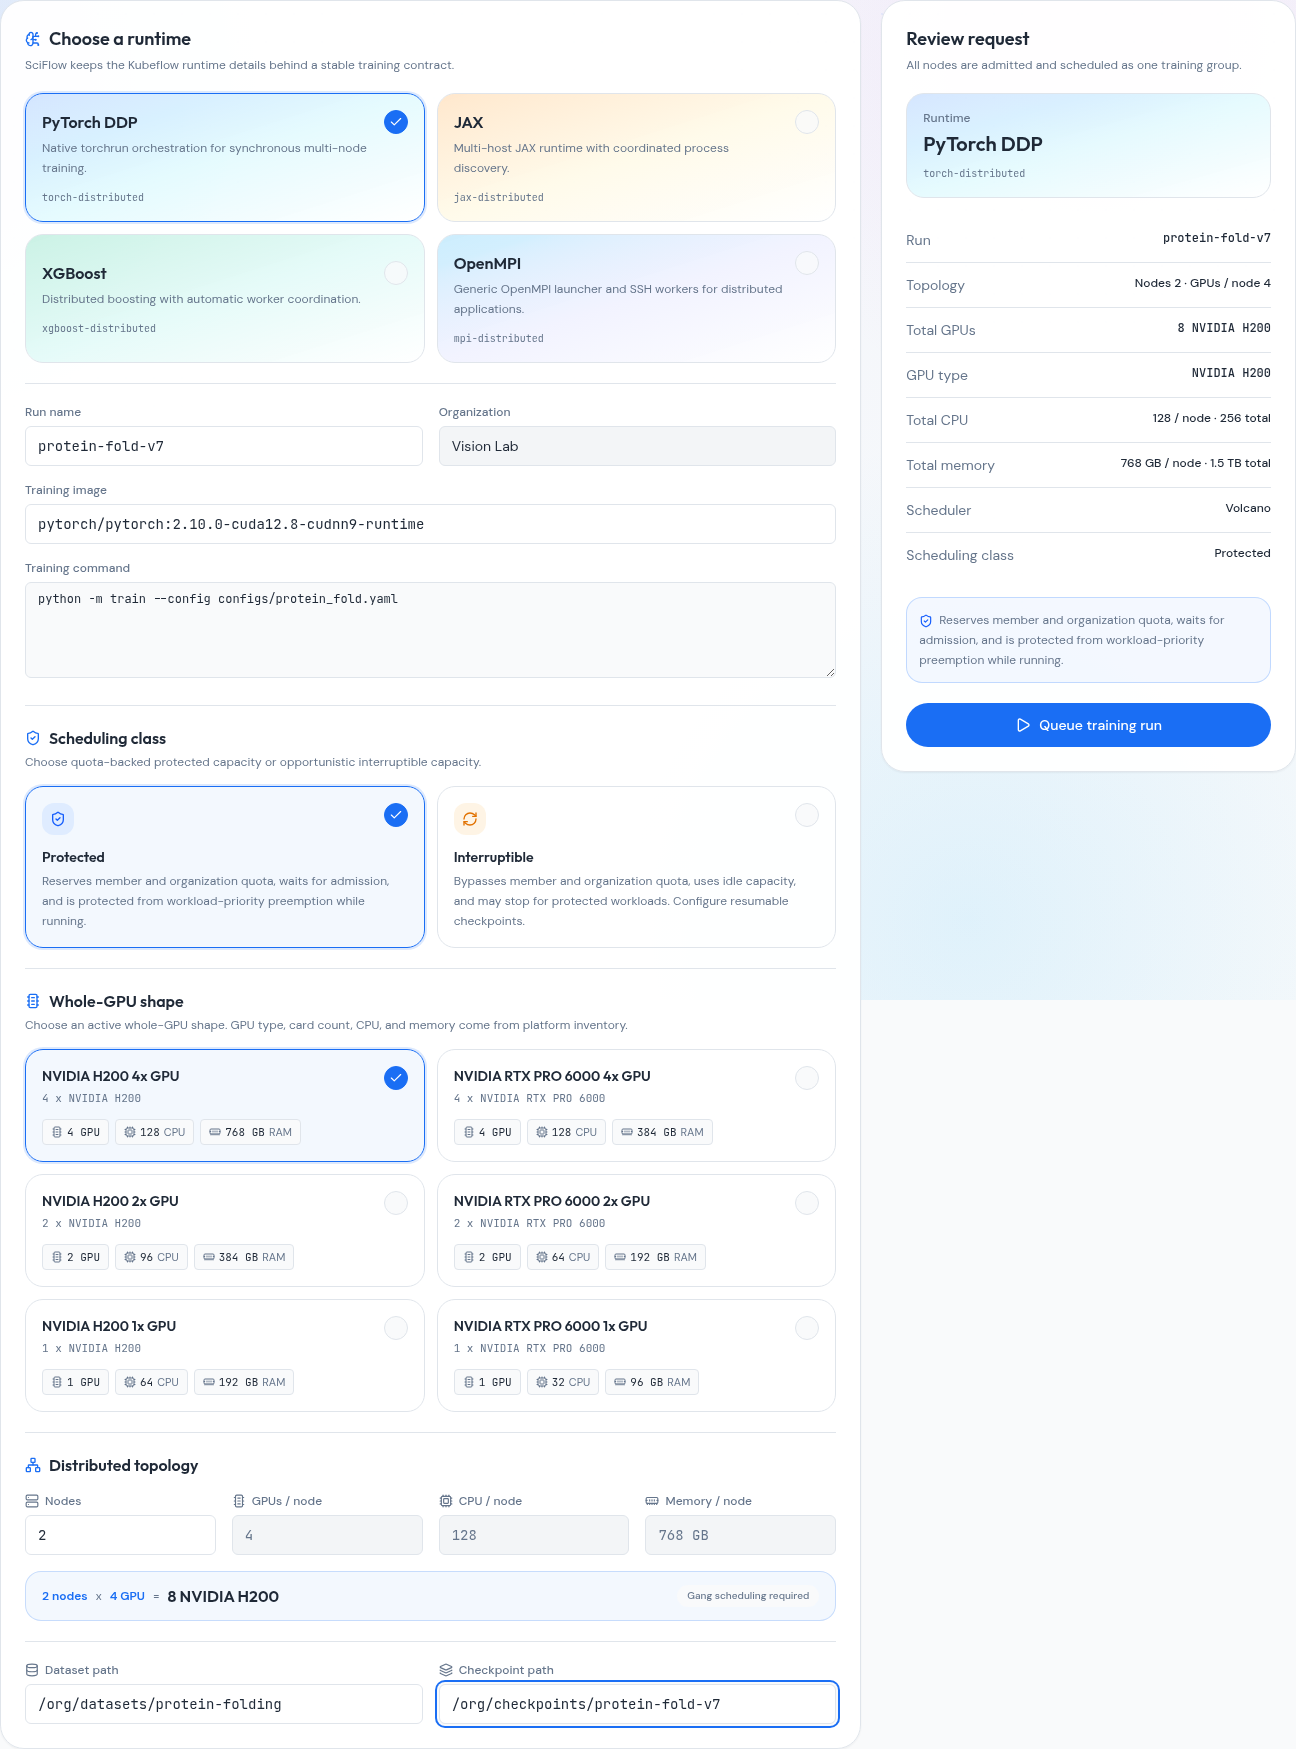
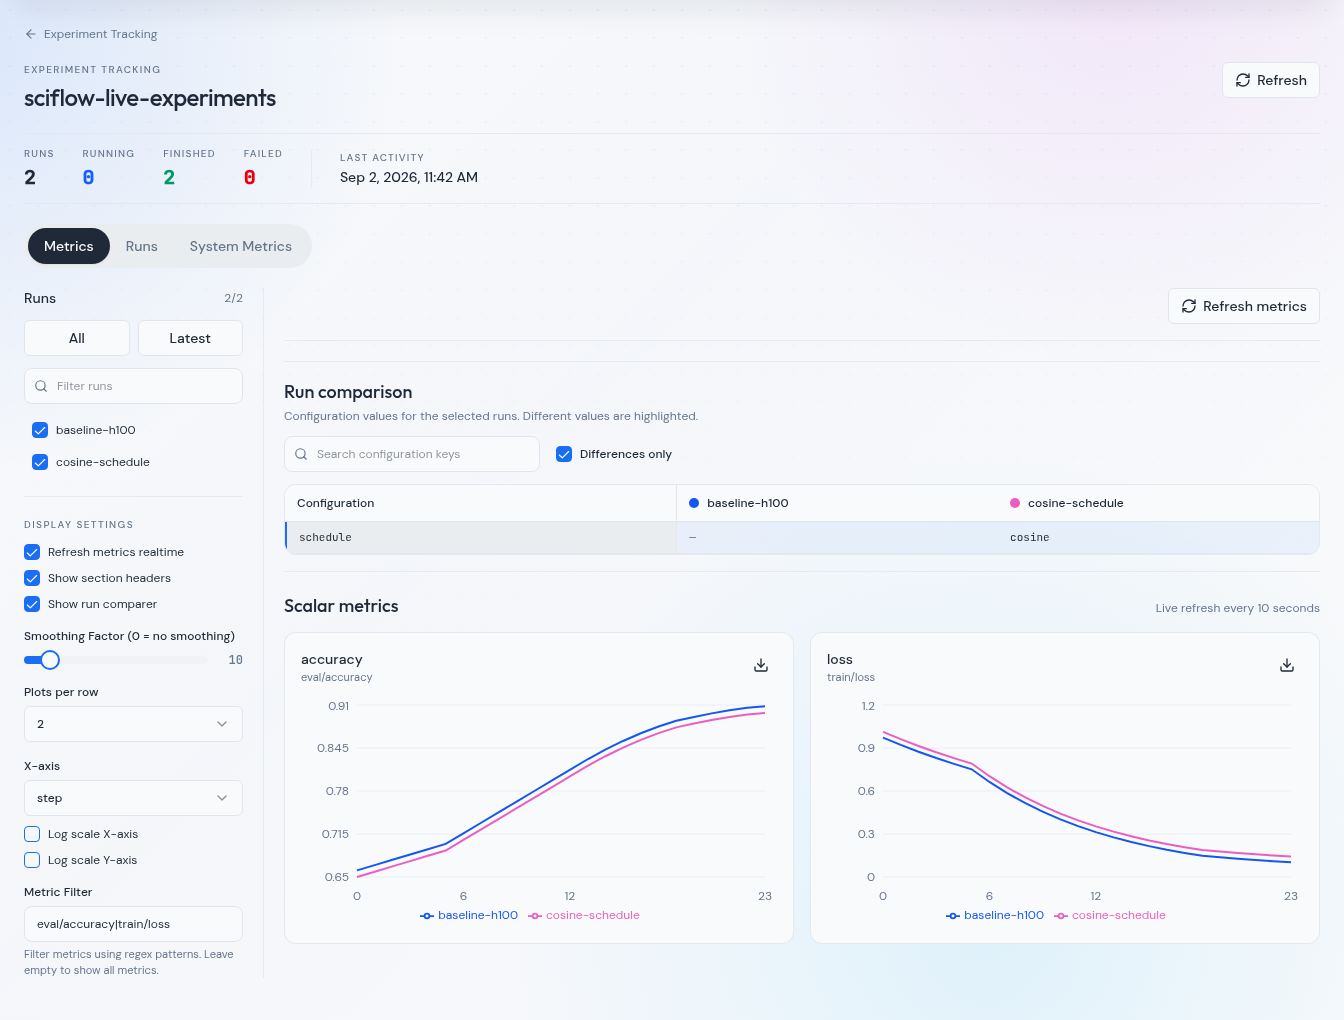
实验追踪
将损失、准确率等实验指标与运行配置保存在一起。在 SciFlow 中对比多次运行,并从结果追溯到对应的实例、作业或分布式训练任务。
无需配置,即可开始记录。
在 SciFlow 工作负载中使用受支持的 wandb 日志接口或 Hugging Face 集成,无需安装追踪包,也无需管理 API 密钥。
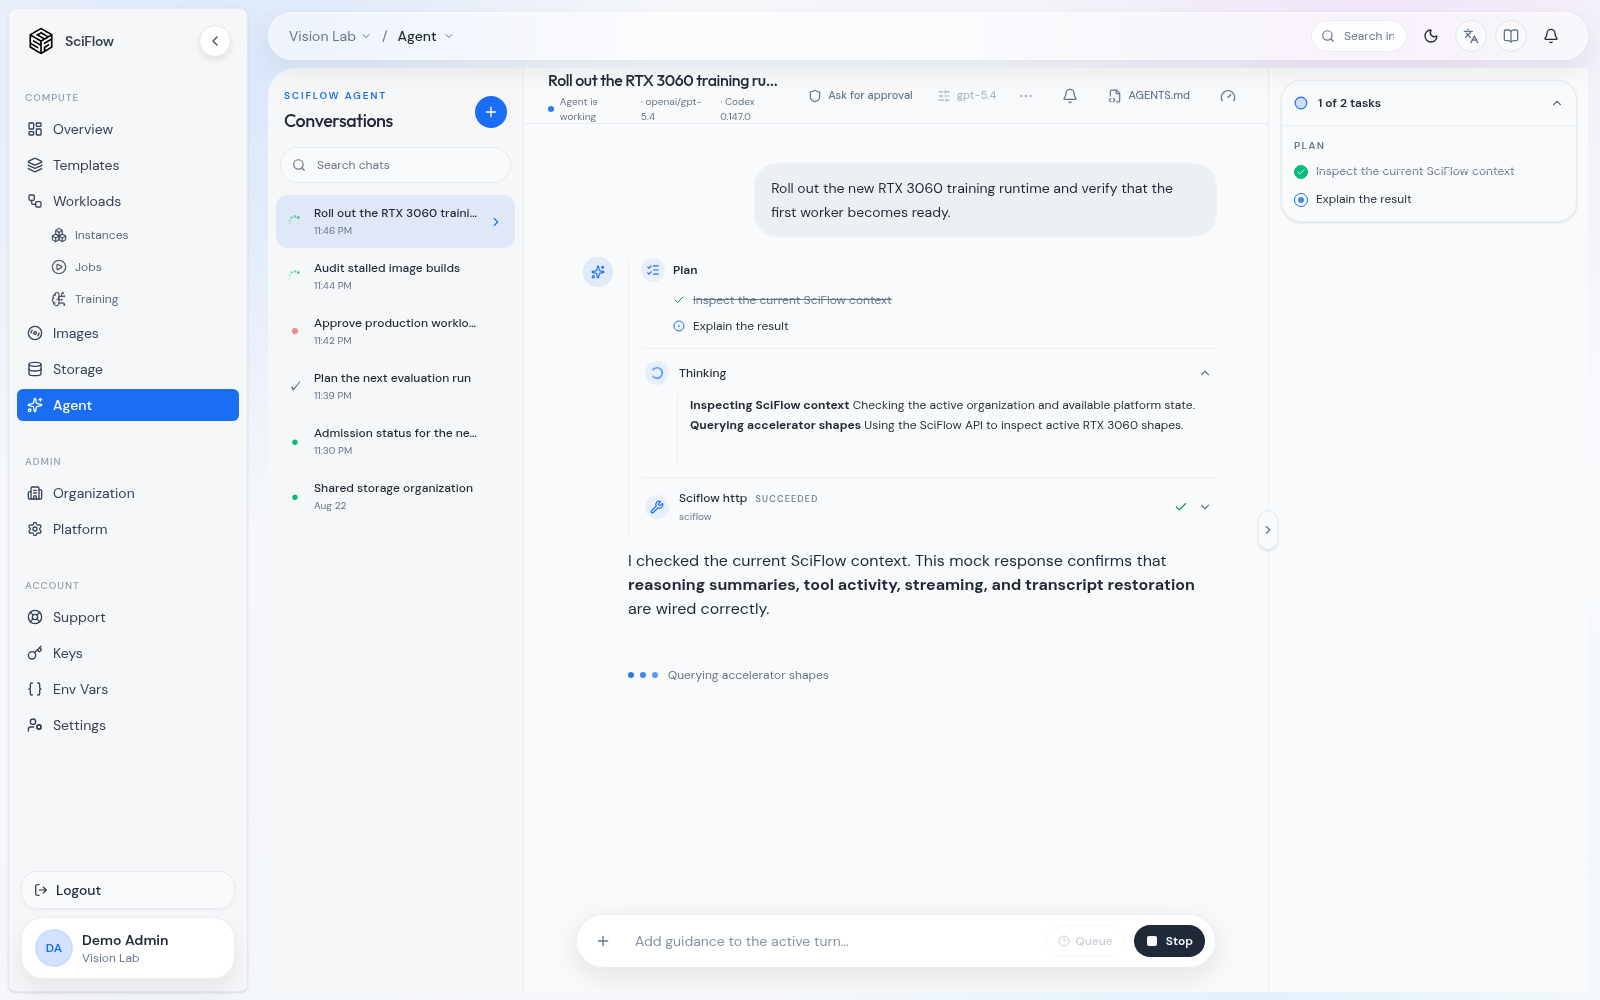
研究智能体
内置智能体能够看到你的工作空间和实时 SciFlow API。它可以检查任务、结合项目上下文推理、生成可视化产物,并在你的权限范围内执行基础设施操作。
辅助始终受策略约束。
API 访问受用户与组织权限约束。写操作遵循所选审批策略:暂停等待审查,或自动执行。两种模式都受平台授权控制。
SciFlow 把实验信号与共享算力策略放在同一上下文中,让研究者能够独立排查问题,并根据真实容量安排下一步工作。
01观察运行状态
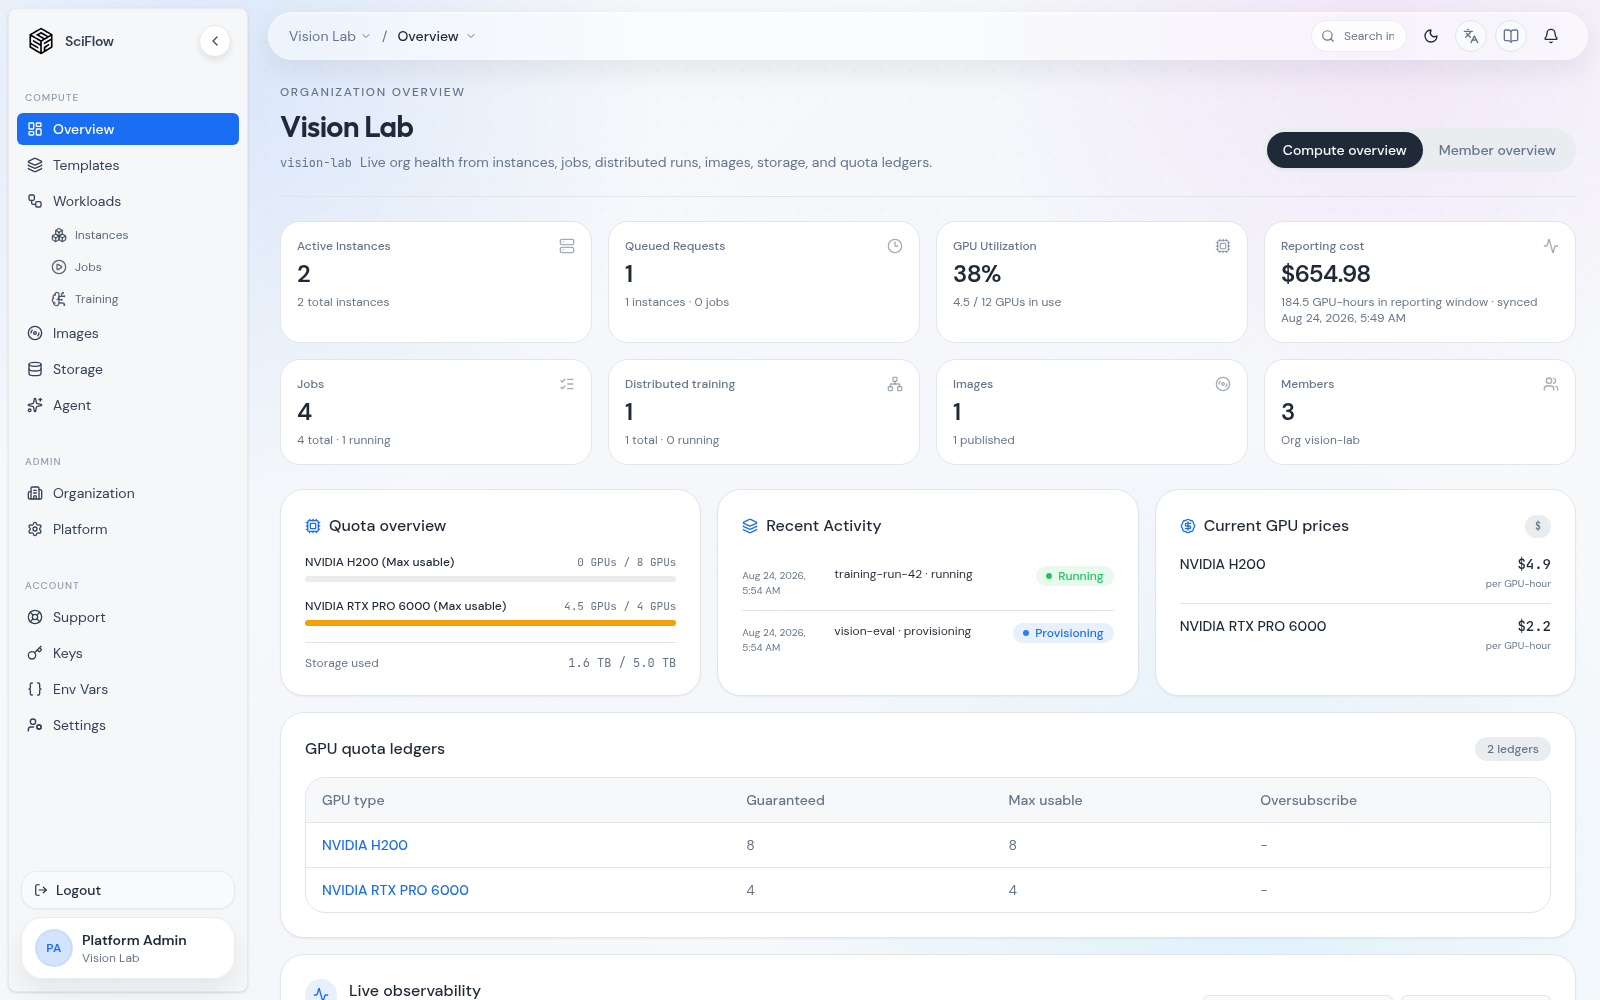
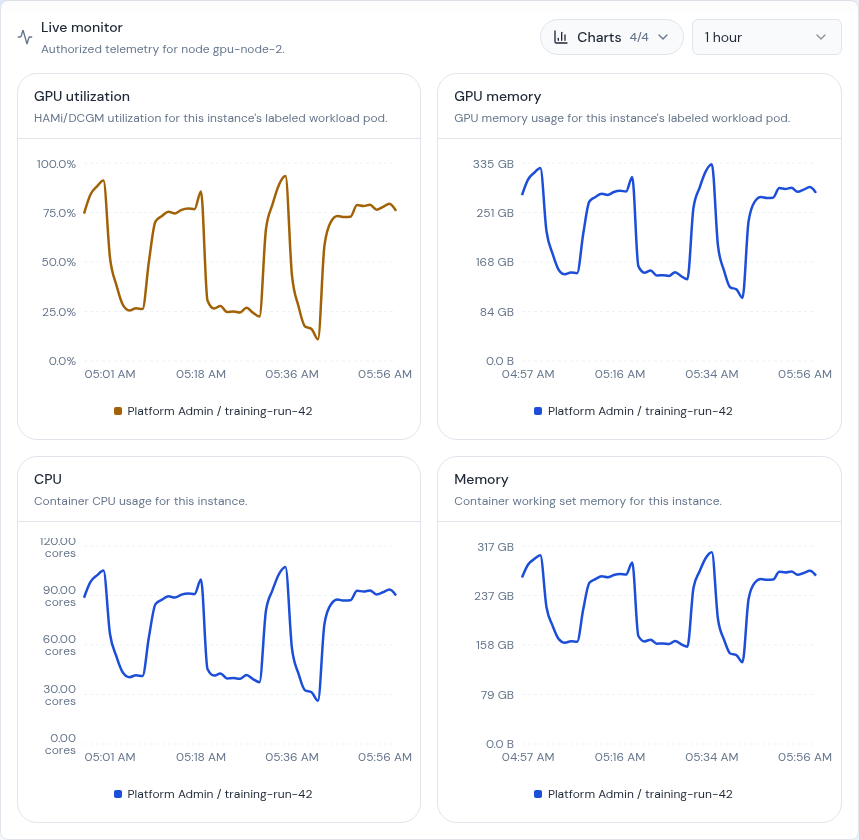
在实验上下文中查看利用率、Rank 健康、日志、事件、调度状态与费用。
02解释等待原因
看清任务是在运行、创建还是排队,以及是哪项资源或策略影响了调度。
03规划下一次启动
在占用稀缺 GPU 之前,先了解可用配额与本次请求的影响。
工作负载可观测性
从快速检查工作空间到多节点训练,工作负载遥测、Rank 状态、筛选日志、调度历史、Kubernetes 事件与使用费用始终关联在同一个研究对象上。
这将如何帮助研究者
研究者运行自己的工作,实验室管理员管理访问和预算,平台团队继续控制策略与 GPU 资源。
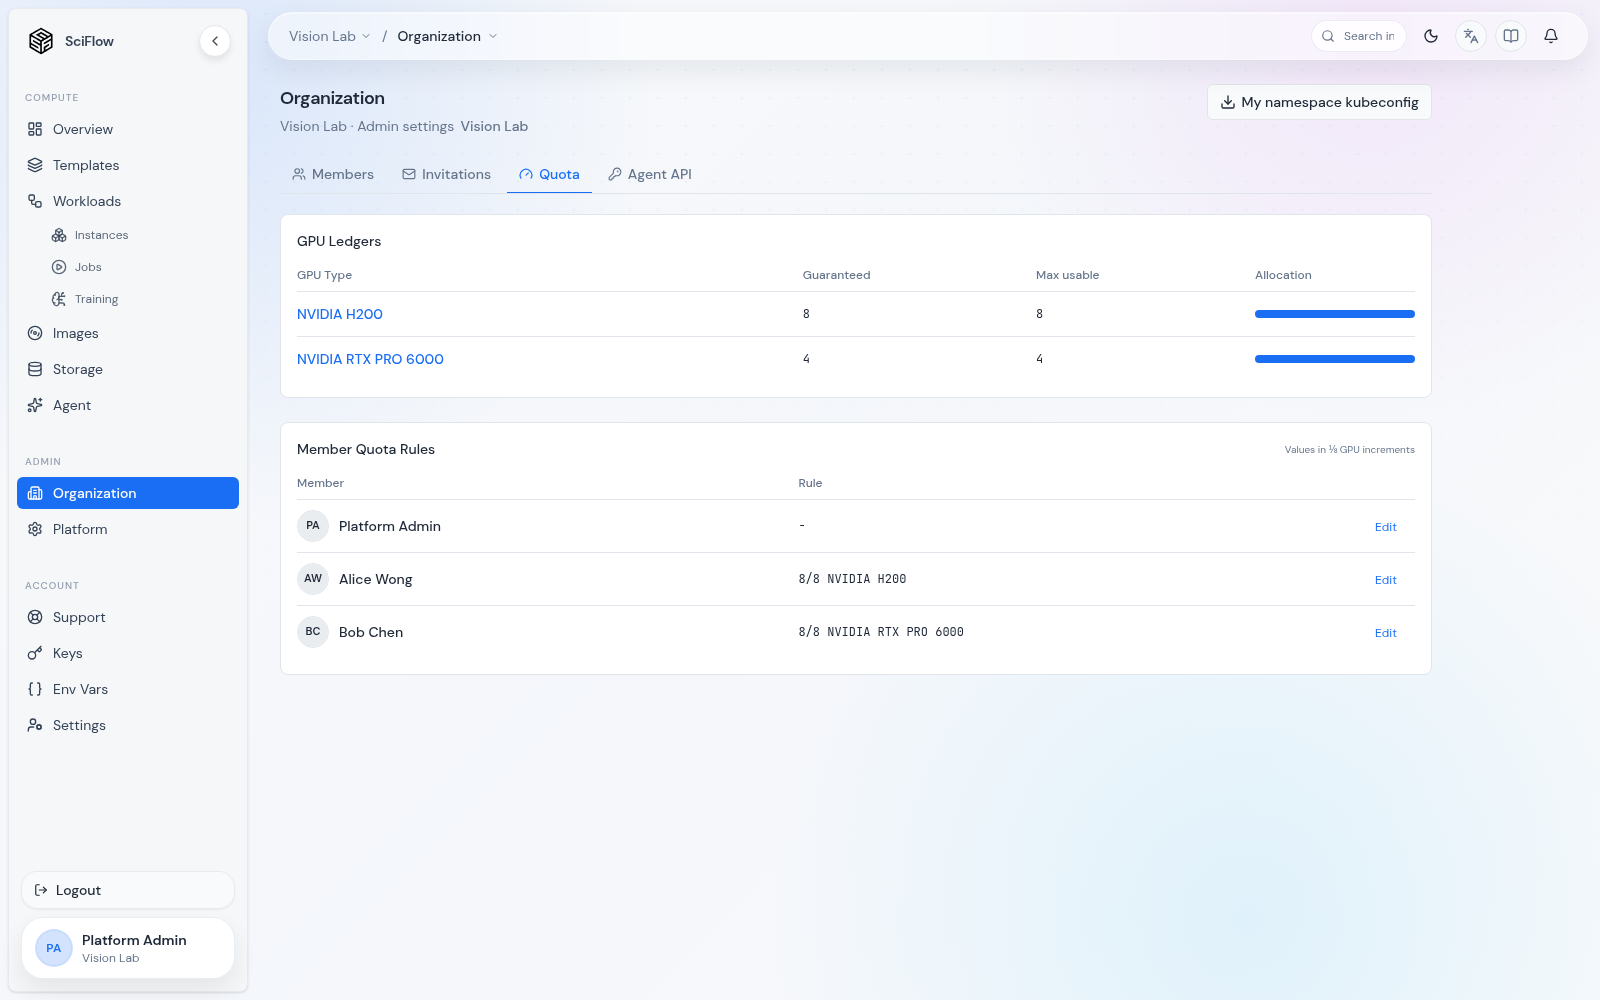
透明配额
SciFlow 把实验室策略变成研究者可以据此行动的信息:按 GPU 类型划分的保障与共享容量、成员级限制、分数 GPU,以及 CPU、内存和存储边界。
这将如何帮助实验室
我们的方向
要真正参与科研,智能体需要在治理边界内访问算力、文件、遥测和实验状态。SciFlow 正在构建这一操作层。
今天
智能体可以检查实验室的实时环境,结合工作空间上下文推理,并按照你的权限与所选审批策略执行平台操作。
方向
同一基础可以支持智能体协调环境、执行、监控与分析,而科学家负责设定意图并审查证据。
申请试用
我们正在与运行私有 GPU 集群的学术团队合作。告诉我们,基础设施在哪些环节拖慢了你的科研。